Email Address Parser
Parse and validate email addresses, including support for obfuscated formats commonly used to avoid spam harvesting (e.g., 'user at example dot com').
Key Concepts
- obfuscation handling
- sanitization
- format normalization
- spam-resistant parsing
- flexible matching
Why Parse This Format?
Email parsing is essential for user registration, contact forms, and communication systems. Handling obfuscated formats helps process user-submitted emails that try to avoid spam bots.
Use Cases
- User registration validation
- Contact form processing
- Email sanitization and normalization
- Spam-resistant email collection
- Data cleaning and deduplication
Input Format
Standard email format (user@domain) and obfuscated formats using 'at' and 'dot' words instead of symbols. Spaces and various delimiters are handled.
username@domain.tld or username at domain dot tldExamples
user@example.comVALIDStandard email format
john.doe@example.comVALIDEmail with dot in username
user at example dot comVALIDObfuscated format (anti-spam)
john-doe-at-example-dot-comVALIDDash-delimited obfuscated format
user AT example DOT comVALIDUppercase obfuscated format
user @ example . comVALIDSpaced standard format
invalid-emailINVALIDInvalid: no @ or 'at' separator
@example.comINVALIDInvalid: missing username
Output Format
The parser returns an EmailParts struct with the sanitized username and domain components.
Structure
usernameString - the local part before @
domainString - the domain part after @
Visual Overview
How the Code Works
This section explains how the parsing rules map to the format semantics.
Local Part Parsing
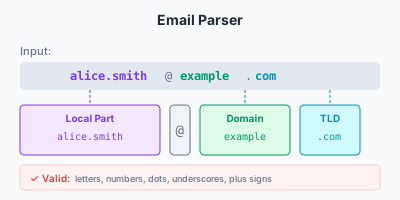
.rule("local", re(r#"[a-zA-Z0-9._%+-]+"#))The local part (before `@`) has specific character rules: Allowed characters include letters, digits, and `._%+-`. The local part cannot start or end with a dot, and cannot have consecutive dots.
Domain Parsing
.rule("domain", seq(vec![
    dynamic(re(r#"[a-zA-Z0-9-]+"#)),
    dynamic(seq(vec![dynamic(str(".")), dynamic(re(r#"[a-zA-Z0-9-]+"#))]).many()),
]))
The domain follows standard DNS rules: Domains have at least two labels separated by dots, with the TLD being alphabetic only.
Separator Detection
.rule("separator", str("@"))The `@` symbol separates local part from domain: Some parsers also handle obfuscated formats like "at" or "[at]" for spam-resistant forms.
Validation Logic
fn validate_email(email: &EmailParts) -> Result<(), String> {
    if email.local.is_empty() { return Err("Empty local part"); }
    if email.local.starts_with('.') || email.local.ends_with('.') {
        return Err("Local part cannot start/end with dot");
    }
    if email.domain.split('.').any(|p| p.is_empty()) {
        return Err("Invalid domain");
    }
    Ok(())
}
Post-parse validation checks semantic rules: The grammar validates syntax; this validates semantics.
Source Code
//! Email Address Parser Example
//!
//! This example demonstrates parsing and sanitizing email addresses.
//! Handles both standard format and obfuscated formats (at/dot).
//! Based on the Parslet email_parser.rb example.
//!
//! Run with: cargo run --example email_parser --no-default-features

#![allow(clippy::print_literal)]

use parsanol::portable::{
    parser_dsl::{choice, dynamic, re, seq, str, GrammarBuilder},
    AstArena, Grammar, PortableParser,
};

/// Build an email grammar
fn build_email_grammar() -> Grammar {
    GrammarBuilder::new()
        // Space characters
        .rule("space", re("[ \\t\\n\\r]+"))
        // Word: alphanumeric sequence
        .rule("word", re("[a-zA-Z0-9]+"))
        // At symbol: @ or "at" or "AT" (with optional dashes)
        .rule(
            "at",
            choice(vec![
                dynamic(str("@")),
                dynamic(seq(vec![
                    dynamic(re("[_-]?")),
                    dynamic(choice(vec![dynamic(str("at")), dynamic(str("AT"))])),
                    dynamic(re("[_-]?")),
                ])),
            ]),
        )
        // Dot: . or "dot" or "DOT" (with optional dashes)
        .rule(
            "dot",
            choice(vec![
                dynamic(str(".")),
                dynamic(seq(vec![
                    dynamic(re("[_-]?")),
                    dynamic(choice(vec![dynamic(str("dot")), dynamic(str("DOT"))])),
                    dynamic(re("[_-]?")),
                ])),
            ]),
        )
        // Username: word followed by optional (dot word) sequences
        .rule(
            "username",
            seq(vec![
                dynamic(re("[a-zA-Z0-9]+")),
                dynamic(re("(?:[ \\t]*[._-][ \\t]*[a-zA-Z0-9]+)*")),
            ]),
        )
        // Domain: word followed by (dot word) sequences
        .rule(
            "domain",
            seq(vec![
                dynamic(re("[a-zA-Z0-9]+")),
                dynamic(re("(?:[ \\t]*[._-][ \\t]*[a-zA-Z0-9]+)+")),
            ]),
        )
        // Full email: username @ domain
        .rule(
            "email",
            seq(vec![
                dynamic(re("[a-zA-Z0-9]+(?:[ \\t]*[._-][ \\t]*[a-zA-Z0-9]+)*")),
                dynamic(re("[ \\t]*")),
                dynamic(choice(vec![
                    dynamic(str("@")),
                    dynamic(re("[_-]?(?:at|AT)[_-]?")),
                ])),
                dynamic(re("[ \\t]*")),
                dynamic(re("[a-zA-Z0-9]+(?:[ \\t]*[._-][ \\t]*[a-zA-Z0-9]+)+")),
            ]),
        )
        .build()
}

/// Parsed email components
#[derive(Debug, Clone)]
pub struct EmailParts {
    pub username: String,
    pub domain: String,
}

impl std::fmt::Display for EmailParts {
    fn fmt(&self, f: &mut std::fmt::Formatter<'_>) -> std::fmt::Result {
        write!(f, "{}@{}", self.username, self.domain)
    }
}

/// Parse an email address
pub fn parse_email(input: &str) -> Result<EmailParts, String> {
    let input = input.trim();
    let grammar = build_email_grammar();
    let mut arena = AstArena::for_input(input.len());
    let mut parser = PortableParser::new(&grammar, input, &mut arena);

    parser
        .parse()
        .map_err(|e| format!("Parse error: {:?}", e))?;

    // Manual parsing for the actual extraction
    // Handle both standard @ and obfuscated "at" formats
    let lower = input.to_lowercase();

    // Find the separator (@, at, AT, etc.)
    let (username_part, domain_part) = if let Some(pos) = input.find('@') {
        (&input[..pos], &input[pos + 1..])
    } else if let Some(pos) = lower.find(" at ") {
        (&input[..pos], &input[pos + 4..])
    } else if let Some(pos) = lower.find("-at-") {
        (&input[..pos], &input[pos + 4..])
    } else if let Some(pos) = lower.find("_at_") {
        (&input[..pos], &input[pos + 4..])
    } else if let Some(pos) = lower.find(" at") {
        (&input[..pos], &input[pos + 3..])
    } else if let Some(pos) = lower.find("at ") {
        (&input[..pos], &input[pos + 3..])
    } else {
        return Err("No email separator (@ or 'at') found".to_string());
    };

    // Clean up: remove spaces and convert dot variations
    let username = sanitize_part(username_part);
    let domain = sanitize_part(domain_part);

    Ok(EmailParts { username, domain })
}

/// Sanitize a part of the email (username or domain)
fn sanitize_part(part: &str) -> String {
    let lower = part.to_lowercase();
    let mut result = String::new();
    let chars: Vec<char> = lower.chars().collect();

    let mut i = 0;
    while i < chars.len() {
        // Check for "dot"
        if i + 3 <= chars.len() && &lower[i..i + 3] == "dot" {
            // Check if surrounded by valid delimiters
            let before_ok = i == 0 || !chars[i - 1].is_alphanumeric();
            let after_ok = i + 3 >= chars.len() || !chars[i + 3].is_alphanumeric();
            if before_ok && after_ok {
                result.push('.');
                i += 3;
                continue;
            }
        }
        // Skip spaces, underscores, dashes (but keep dots)
        let c = chars[i];
        if c == ' ' || c == '_' || c == '-' {
            // Skip
        } else {
            result.push(c);
        }
        i += 1;
    }

    result
}

fn main() {
    println!("Email Address Parser Example");
    println!("============================\n");

    let emails = [
        // Standard format
        "user@example.com",
        "john.doe@example.com",
        "a.b.c.d@gmail.com",
        // With spaces
        "user @ example.com",
        "john . doe @ example . com",
        // Obfuscated format
        "user at example dot com",
        "john-doe-at-example-dot-com",
        "john_doe_at_example_dot_com",
        "user AT example DOT com",
        // Mixed
        "first.last at gmail.com",
        "test-user@example dot org",
    ];

    println!("{:<40} | {}", "Input", "Parsed Email");
    println!("{}", "-".repeat(70));

    for email in emails {
        match parse_email(email) {
            Ok(parts) => {
                println!("{:<40} | {}", email, parts);
            }
            Err(e) => {
                println!("{:<40} | ERROR: {}", email, e);
            }
        }
    }

    // Demonstrate sanitization
    println!("\nSanitization Examples:");
    println!("-----------------------");
    let examples = [
        ("user at example dot com", "user@example.com"),
        ("john.doe @ example . com", "john.doe@example.com"),
        ("test-user-at-gmail-dot-com", "testuser@gmail.com"),
    ];

    for (input, expected) in examples {
        if let Ok(parts) = parse_email(input) {
            let result = format!("{}@{}", parts.username, parts.domain);
            let status = if result == expected { "✓" } else { "✗" };
            println!(
                "  {} {} -> {} (expected: {})",
                status, input, result, expected
            );
        }
    }
}
#!/usr/bin/env ruby
# frozen_string_literal: true

# Email address parser with sanitization support.
# Originally contributed to Parslet, ported to Parsanol as an example.

$LOAD_PATH.unshift "#{File.dirname(__FILE__)}/../lib"
require "parsanol/parslet"
require "parsanol/convenience"

class EmailParser < Parsanol::Parser
  rule(:space) { match('\s').repeat(1) }
  rule(:space?) { space.maybe }
  rule(:dash?) { match["_-"].maybe }

  rule(:at) do
    str("@") |
      (dash? >> (str("at") | str("AT")) >> dash?)
  end
  rule(:dot) do
    str(".") |
      (dash? >> (str("dot") | str("DOT")) >> dash?)
  end

  rule(:word) { match("[a-z0-9]").repeat(1).as(:word) >> space? }
  rule(:separator) { (dot.as(:dot) >> space?) | space }
  rule(:words) { word >> (separator >> word).repeat }

  rule(:email) do
    (words.as(:username) >> space? >> at >> space? >> words).as(:email)
  end

  root(:email)
end

class EmailSanitizer < Parsanol::Transform
  rule(dot: simple(:dot), word: simple(:word)) { ".#{word}" }
  rule(word: simple(:word)) { word }

  rule(username: sequence(:username)) { "#{username.join}@" }
  rule(username: simple(:username)) { "#{username}@" }

  rule(email: sequence(:email)) { email.join }
end

parser = EmailParser.new
sanitizer = EmailSanitizer.new

input = ARGV[0] || begin
  default = "a.b.c.d@gmail.com"
  warn "usage: #{$PROGRAM_NAME} \"EMAIL_ADDR\""
  $stdout.puts "since you haven't specified any EMAIL_ADDR, for testing purposes we're using #{default}"
  default
end

p sanitizer.apply(parser.parse_with_debug(input))