Markdown Parser
Parse a comprehensive subset of Markdown including headers, paragraphs, code blocks, lists, blockquotes, links, images, and inline formatting.
Key Concepts
- block parsing
- inline formatting
- fenced code blocks
- list detection
- link/image parsing
Why Parse This Format?
Markdown is the most widely used lightweight markup language for documentation, blogging, and content management. A robust parser enables custom documentation tooling.
Use Cases
- Static site generators
- Documentation systems
- README rendering
- Blog post processing
- Content management systems
Input Format
Markdown with ATX headers (# to ######), code blocks (```), blockquotes (>), unordered lists (- or *), ordered lists (1.), horizontal rules (---), links [text](url), images , and inline formatting.
# Header | ```code``` | > quote | - list | [link](url) | **bold** | *italic* | `code`Examples
# Title\n\nParagraph text.VALIDHeader and paragraph
```rust\nfn main() {}\n```VALIDFenced code block
- Item 1\n- Item 2\n- Item 3VALIDUnordered list
1. First\n2. Second\n3. ThirdVALIDOrdered list
> This is a blockquoteVALIDBlockquote
[Link text](https://example.com)VALIDLink
VALIDImage
---VALIDHorizontal rule
# Full\n\nText with **bold**, *italic*, and `code`.\n\n- List\n- ItemsVALIDFull document
Output Format
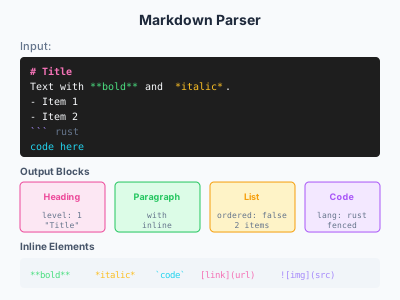
The parser returns a MarkdownDocument containing MdBlock enum values for each block element.
Structure
MarkdownDocumentStruct with blocks: Vec<MdBlock>
MdBlockEnum: Heading{level, text}, Paragraph{text}, CodeBlock{language, code}, Blockquote{text}, List{ordered, items}, HorizontalRule, Blank
Visual Overview
How the Code Works
This section explains how the parsing rules map to the format semantics.
ATX Header Parsing
.rule(
    "atx_header",
    seq(vec![
        dynamic(re("[ \t]*")),
        dynamic(re("#{1,6}")),     // 1-6 hashes
        dynamic(re("[ \t]+")),     // required space
        dynamic(re("[^\\n\\r]+")), // header text
    ]),
)
Headers use 1-6 `#` characters: The space after `#` is required by CommonMark spec.
Code Block Parsing
.rule(
    "code_block",
    seq(vec![
        dynamic(str("```")),
        dynamic(re("[a-zA-Z0-9+-]*")), // optional language
        dynamic(re("[\r]?[\n]")),
        dynamic(re(".*?")), // code content (non-greedy)
        dynamic(re("[\r]?[\n]")),
        dynamic(str("```")),
    ]),
)
Fenced code blocks use triple backticks: Language specification is optional.
Emphasis Parsing
.rule("italic", re("\\*[^*]+\\*"))
.rule("bold", re("\\*\\*[^*]+\\*\\*"))
.rule("bold_italic", re("\\*\\*\\*[^*]+\\*\\*\\*"))
Inline emphasis uses asterisks: Bold-italic (`***`) must be checked before bold (`**`) and italic (`*`).
Link and Image Parsing
.rule(
    "link",
    seq(vec![
        dynamic(str("[")),
        dynamic(re("[^\\]]+")), // text
        dynamic(str("]")),
        dynamic(str("(")),
        dynamic(re("[^)]+")), // url
        dynamic(str(")")),
    ]),
)
.rule(
    "image",
    seq(vec![
        dynamic(str("![")),
        dynamic(re("[^\\]]+")), // alt text
        dynamic(str("]")),
        dynamic(str("(")),
        dynamic(re("[^)]+")), // url
        dynamic(str(")")),
    ]),
)
Links and images use bracket syntax: Images are distinguished by the leading `!`.
List Parsing
// Unordered list
if trimmed.starts_with("- ") || trimmed.starts_with("* ") {
    let item = trimmed[2..].trim().to_string();
    if let Some((_, ref mut items)) = current_list {
        items.push(item);
    } else {
        current_list = Some((false, vec![item]));
    }
}

// Ordered list
if let Some(pos) = trimmed.find(". ") {
    if pos > 0 && trimmed[..pos].chars().all(|c| c.is_ascii_digit()) {
        let item = trimmed[pos + 2..].trim().to_string();
        // ...
    }
}
Lists are accumulated until a non-list line: The `flush_list` helper emits completed lists.
Source Code
//! Markdown Subset Parser Example
//!
//! This example demonstrates parsing a subset of Markdown, a lightweight markup
//! language for creating formatted text. Markdown is widely used for documentation,
//! blogs, and README files.
//!
//! Supported features:
//! - Headers: # H1, ## H2, ### H3
//! - Paragraphs: plain text separated by blank lines
//! - Emphasis: *italic*, **bold**, ***bold italic***
//! - Inline code: `code`
//! - Links: [text](url)
//! - Images: 
//! - Lists: - item, 1. item
//! - Blockquotes: > quote
//! - Code blocks: ```language ... ```
//! - Horizontal rules: --- or ***
//!
//! Run with: cargo run --example markdown/basic --no-default-features
use parsanol::portable::{
parser_dsl::{choice, dynamic, re, seq, str, GrammarBuilder, ParsletExt},
AstArena, Grammar, PortableParser,
};
use serde::{Deserialize, Serialize};
/// Build Markdown grammar (subset)
fn build_markdown_grammar() -> Grammar {
GrammarBuilder::new()
// Headers: # H1, ## H2, ### H3, etc.
.rule(
"atx_header",
seq(vec![
dynamic(re("[ \t]*")),
dynamic(re("#{1,6}")), // 1-6 hashes
dynamic(re("[ \t]+")), // required space
dynamic(re("[^\\n\\r]+")), // header text
]),
)
// Setext headers: H1 underline, H2 underline
.rule(
"setext_h1",
seq(vec![
dynamic(re("[^\\n\\r]+")), // text
dynamic(re("[\r]?[\n]")),
dynamic(re("={3,}")), // === underline
]),
)
.rule(
"setext_h2",
seq(vec![
dynamic(re("[^\\n\\r]+")), // text
dynamic(re("[\r]?[\n]")),
dynamic(re("-{3,}")), // --- underline
]),
)
// Horizontal rule: --- or *** or ___
.rule(
"hr",
seq(vec![
dynamic(re("[ \t]*")),
dynamic(re("(-[ \t]*){3,}|(\\*[ \t]*){3,}|(_[ \t]*){3,}")),
dynamic(re("[ \t]*")),
]),
)
// Code block: ```
.rule(
"code_block",
seq(vec![
dynamic(str("```")),
dynamic(re("[a-zA-Z0-9+-]*")), // optional language
dynamic(re("[\r]?[\n]")),
dynamic(re(".*?")), // code content (non-greedy)
dynamic(re("[\r]?[\n]")),
dynamic(str("```")),
]),
)
// Inline code: `code`
.rule(
"inline_code",
seq(vec![
dynamic(str("`")),
dynamic(re("[^`]+")),
dynamic(str("`")),
]),
)
// Emphasis: *italic*, **bold**, ***both***
.rule("italic", re("\\*[^*]+\\*"))
.rule("bold", re("\\*\\*[^*]+\\*\\*"))
.rule("bold_italic", re("\\*\\*\\*[^*]+\\*\\*\\*"))
// Link: [text](url)
.rule(
"link",
seq(vec![
dynamic(str("[")),
dynamic(re("[^\\]]+")), // text
dynamic(str("]")),
dynamic(str("(")),
dynamic(re("[^)]+")), // url
dynamic(str(")")),
]),
)
// Image: 
.rule(
"image",
seq(vec![
dynamic(str("![")),
dynamic(re("[^\\]]+")), // alt text
dynamic(str("]")),
dynamic(str("(")),
dynamic(re("[^)]+")), // url
dynamic(str(")")),
]),
)
// Blockquote: > quote
.rule(
"blockquote",
seq(vec![
dynamic(re("[ \t]*")),
dynamic(str(">")),
dynamic(re("[ \t]*")),
dynamic(re("[^\\n\\r]+")),
]),
)
// Unordered list: - item or * item
.rule(
"ul_item",
seq(vec![
dynamic(re("[ \t]*")),
dynamic(str("-").or(str("*"))),
dynamic(re("[ \t]+")),
dynamic(re("[^\\n\\r]+")),
]),
)
// Ordered list: 1. item
.rule(
"ol_item",
seq(vec![
dynamic(re("[ \t]*")),
dynamic(re("[0-9]+")),
dynamic(str(".")),
dynamic(re("[ \t]+")),
dynamic(re("[^\\n\\r]+")),
]),
)
// Paragraph: text separated by blank lines
.rule("paragraph", re("[^#\\-*_>`\\n\\r][^\\n\\r]+"))
// Blank line
.rule("blank", re("[ \t]*[\r]?[\n]"))
// Inline elements (for parsing within paragraphs)
.rule(
"inline",
choice(vec![
dynamic(re("!\\[[^\\]]+\\]\\([^)]+\\)")), // image
dynamic(re("\\[[^\\]]+\\]\\([^)]+\\)")), // link
dynamic(re("`[^`]+`")), // inline code
dynamic(re("\\*\\*\\*[^*]+\\*\\*\\*")), // bold italic
dynamic(re("\\*\\*[^*]+\\*\\*")), // bold
dynamic(re("\\*[^*]+\\*")), // italic
dynamic(re("[^\\[*_`\n\\r]+")), // plain text
]),
)
// Block elements
.rule(
"block",
choice(vec![
dynamic(re("```[a-zA-Z0-9+-]*[\r]?[\n].*?[\r]?[\n]```")), // code block
dynamic(re("#{1,6}[ \t]+[^\\n\\r]+")), // atx header
dynamic(re(">[ \t]*[^\\n\\r]+")), // blockquote
dynamic(re("(-[ \t]*){3,}|(\\*[ \t]*){3,}")), // hr
dynamic(re("[0-9]+\\.[ \t]+[^\\n\\r]+")), // ordered list
dynamic(re("[-*][ \t]+[^\\n\\r]+")), // unordered list
dynamic(re("[^#\\-*_>`\\n\\r][^\\n\\r]*")), // paragraph
dynamic(re("[ \t]*")), // blank
]),
)
// Document: sequence of blocks
.rule(
"document",
seq(vec![
dynamic(
seq(vec![
dynamic(choice(vec![
dynamic(re("```[a-zA-Z0-9+-]*[\r]?[\n].*?[\r]?[\n]```")),
dynamic(re("#{1,6}[ \t]+[^\\n\\r]+")),
dynamic(re(">[ \t]*[^\\n\\r]+")),
dynamic(re("(-[ \t]*){3,}|(\\*[ \t]*){3,}")),
dynamic(re("[0-9]+\\.[ \t]+[^\\n\\r]+")),
dynamic(re("[-*][ \t]+[^\\n\\r]+")),
dynamic(re("[^#\\-*_>`\\n\\r][^\\n\\r]*")),
dynamic(re("[ \t]*")),
])),
dynamic(re("[\r]?[\n]")),
])
.many(),
),
dynamic(
choice(vec![
dynamic(re("#{1,6}[ \t]+[^\\n\\r]+")),
dynamic(re(">[ \t]*[^\\n\\r]+")),
dynamic(re("[-*][ \t]+[^\\n\\r]+")),
dynamic(re("[^#\\-*_>`\\n\\r][^\\n\\r]*")),
dynamic(re("[ \t]*")),
])
.optional(),
),
]),
)
.build()
}
/// Markdown block types
#[derive(Debug, Clone, Serialize, Deserialize)]
#[serde(tag = "type")]
pub enum MdBlock {
#[serde(rename = "heading")]
Heading { level: u8, text: String },
#[serde(rename = "paragraph")]
Paragraph { text: String },
#[serde(rename = "code_block")]
CodeBlock {
language: Option<String>,
code: String,
},
#[serde(rename = "blockquote")]
Blockquote { text: String },
#[serde(rename = "list")]
List { ordered: bool, items: Vec<String> },
#[serde(rename = "hr")]
HorizontalRule,
#[serde(rename = "blank")]
Blank,
}
/// Parsed Markdown document
#[derive(Debug, Clone, Serialize, Deserialize)]
pub struct MarkdownDocument {
pub blocks: Vec<MdBlock>,
}
/// Parse Markdown string
pub fn parse_markdown(input: &str) -> Result<String, String> {
let grammar = build_markdown_grammar();
let mut arena = AstArena::for_input(input.len());
let mut parser = PortableParser::new(&grammar, input, &mut arena);
let _ast = parser
.parse()
.map_err(|e| format!("Parse error: {:?}", e))?;
// Manual parsing for structured output
let doc = parse_markdown_document(input)?;
serde_json::to_string_pretty(&doc).map_err(|e| e.to_string())
}
/// Parse a Markdown document
fn parse_markdown_document(input: &str) -> Result<MarkdownDocument, String> {
let mut blocks = Vec::new();
let mut in_code_block = false;
let mut code_content = String::new();
let mut code_lang: Option<String> = None;
let mut current_list: Option<(bool, Vec<String>)> = None; // (ordered, items)
for line in input.lines() {
// Handle code blocks
if line.trim().starts_with("```") {
if in_code_block {
// End code block
blocks.push(MdBlock::CodeBlock {
language: code_lang.take(),
code: code_content.trim_end().to_string(),
});
code_content.clear();
in_code_block = false;
} else {
// Start code block
in_code_block = true;
code_lang = if line.trim().len() > 3 {
Some(line.trim()[3..].to_string())
} else {
None
};
}
continue;
}
if in_code_block {
code_content.push_str(line);
code_content.push('\n');
continue;
}
// Finish any pending list
let trimmed = line.trim();
// ATX headers: # H1
if trimmed.starts_with('#') {
flush_list(&mut current_list, &mut blocks);
let hash_count = trimmed.chars().take_while(|&c| c == '#').count() as u8;
let text = trimmed[hash_count as usize..].trim().to_string();
blocks.push(MdBlock::Heading {
level: hash_count,
text,
});
continue;
}
// Horizontal rule
if is_horizontal_rule(trimmed) {
flush_list(&mut current_list, &mut blocks);
blocks.push(MdBlock::HorizontalRule);
continue;
}
// Blockquote
if trimmed.starts_with('>') {
flush_list(&mut current_list, &mut blocks);
let text = trimmed.strip_prefix('>').unwrap_or("").trim().to_string();
blocks.push(MdBlock::Blockquote { text });
continue;
}
// Unordered list
if trimmed.starts_with("- ") || trimmed.starts_with("* ") {
let item = trimmed[2..].trim().to_string();
if let Some((_, ref mut items)) = current_list {
items.push(item);
} else {
current_list = Some((false, vec![item]));
}
continue;
}
// Ordered list
if let Some(pos) = trimmed.find(". ") {
if pos > 0 && trimmed[..pos].chars().all(|c| c.is_ascii_digit()) {
let item = trimmed[pos + 2..].trim().to_string();
if let Some((_, ref mut items)) = current_list {
items.push(item);
} else {
current_list = Some((true, vec![item]));
}
continue;
}
}
// Blank line
if trimmed.is_empty() {
flush_list(&mut current_list, &mut blocks);
continue;
}
// Paragraph
flush_list(&mut current_list, &mut blocks);
blocks.push(MdBlock::Paragraph {
text: trimmed.to_string(),
});
}
// Handle any remaining content
if in_code_block {
blocks.push(MdBlock::CodeBlock {
language: code_lang,
code: code_content.trim_end().to_string(),
});
}
flush_list(&mut current_list, &mut blocks);
Ok(MarkdownDocument { blocks })
}
fn flush_list(list: &mut Option<(bool, Vec<String>)>, blocks: &mut Vec<MdBlock>) {
if let Some((ordered, items)) = list.take() {
if !items.is_empty() {
blocks.push(MdBlock::List { ordered, items });
}
}
}
fn is_horizontal_rule(s: &str) -> bool {
let s = s.trim();
if s.is_empty() {
return false;
}
let first_char = s.chars().next().unwrap();
if first_char != '-' && first_char != '*' && first_char != '_' {
return false;
}
let count = s.chars().filter(|&c| c == first_char).count();
count >= 3 && s.chars().all(|c| c == first_char || c == ' ' || c == '\t')
}
fn main() {
println!("Markdown Subset Parser Example");
println!("==============================\n");
let examples = [
(
r#"# Main Title
This is a paragraph with **bold** and *italic* text.
## Section 1
- Item one
- Item two
- Item three
### Subsection
1. First
2. Second
3. Third
> This is a blockquote
---
```rust
fn main() {
println!("Hello, world!");
}
```
[Link text](https://example.com)
"#,
"Full document",
),
(
r#"# Quick Start
1. Install dependencies
2. Run the server
3. Open browser
**Done!**
"#,
"Simple document",
),
];
for (input, description) in examples {
println!("Input: ({})", description);
println!("{}\n", input);
match parse_markdown(input) {
Ok(json) => println!("Output:\n{}\n", json),
Err(e) => println!("Error: {}\n", e),
}
println!("{}", "-".repeat(60));
println!();
}
}
# frozen_string_literal: true

# Markdown Parser - Ruby Implementation
#
# Parse a subset of Markdown: headers, paragraphs, lists, code blocks.
#
# Run with: ruby example/markdown/basic.rb

$LOAD_PATH.unshift "#{File.dirname(__FILE__)}/../lib"

require "parsanol/parslet"

# Markdown parser
class MarkdownParser < Parsanol::Parser
  root :document

  # Document is a sequence of blocks
  rule(:document) { block.repeat(1).as(:document) }

  # Block-level elements
  rule(:block) do
    code_block |
      heading |
      blockquote |
      unordered_list |
      ordered_list |
      paragraph
  end

  # Heading: # to ######
  rule(:heading) do
    (str("#").repeat(1, 6).as(:level) >>
     space >>
     heading_content.as(:text) >>
     newline).as(:heading)
  end

  rule(:heading_content) do
    (newline.absent? >> any).repeat(1)
  end

  # Paragraph: text until blank line
  rule(:paragraph) do
    (paragraph_line >> newline).repeat(1).as(:paragraph)
  end

  rule(:paragraph_line) do
    (blank_line.absent? >> (str("#").absent? | space.absent?) >> any).repeat(1)
  end

  # Code block: ``` ... ```
  rule(:code_block) do
    (str("```") >>
     (str("`").absent? >> any).repeat.as(:language) >>
     newline >>
     code_content.as(:code) >>
     str("```") >>
     newline?).as(:code_block)
  end

  rule(:code_content) do
    (str("```").absent? >> any).repeat
  end

  # Blockquote: > text
  rule(:blockquote) do
    (str(">") >>
     space? >>
     quote_content.as(:text) >>
     newline).as(:blockquote)
  end

  rule(:quote_content) do
    (newline.absent? >> any).repeat(1)
  end

  # Unordered list: - or * items
  rule(:unordered_list) do
    unordered_item.repeat(1).as(:unordered_list)
  end

  rule(:unordered_item) do
    (match("[*-]") >>
     space >>
     list_content.as(:text) >>
     newline).as(:item)
  end

  # Ordered list: 1. items
  rule(:ordered_list) do
    ordered_item.repeat(1).as(:ordered_list)
  end

  rule(:ordered_item) do
    (match("[0-9]").repeat(1).as(:number) >>
     str(".") >>
     space >>
     list_content.as(:text) >>
     newline).as(:item)
  end

  rule(:list_content) do
    (newline.absent? >> any).repeat(1)
  end

  # Inline elements
  rule(:inline) do
    bold |
      italic |
      code_inline |
      link |
      text
  end

  rule(:bold) do
    (str("**") >>
     (str("**").absent? >> any).repeat(1).as(:text) >>
     str("**")).as(:bold)
  end

  rule(:italic) do
    (str("*") >>
     (str("*").absent? >> any).repeat(1).as(:text) >>
     str("*")).as(:italic)
  end

  rule(:code_inline) do
    (str("`") >>
     (str("`").absent? >> any).repeat(1).as(:code) >>
     str("`")).as(:code)
  end

  rule(:link) do
    (str("[") >>
     (str("]").absent? >> any).repeat(1).as(:text) >>
     str("]") >>
     str("(") >>
     (str(")").absent? >> any).repeat(1).as(:url) >>
     str(")")).as(:link)
  end

  rule(:text) do
    any.repeat(1).as(:text)
  end

  # Helpers
  rule(:space) { str(" ") }
  rule(:space?) { match('\s').repeat }
  rule(:newline) { match('\n') }
  rule(:newline?) { match('\n').maybe }
  rule(:blank_line) { match('\s').repeat >> newline }
end

# Markdown node classes
Document = Struct.new(:children) do
  def to_html
    children.map { |c| c.respond_to?(:to_html) ? c.to_html : c.to_s }.join("\n")
  end
end

Heading = Struct.new(:level, :text) do
  def to_html
    h = level.length
    "<h#{h}>#{text}</h#{h}>"
  end
end

Paragraph = Struct.new(:lines) do
  def to_html
    "<p>#{lines.map(&:strip).join(' ')}</p>"
  end
end

CodeBlock = Struct.new(:language, :code) do
  def to_html
    "<pre><code class=\"#{language}\">#{code}</code></pre>"
  end
end

Blockquote = Struct.new(:text) do
  def to_html
    "<blockquote>#{text}</blockquote>"
  end
end

UnorderedList = Struct.new(:items) do
  def to_html
    html = items.map { |i| "<li>#{i[:text]}</li>" }.join("\n")
    "<ul>\n#{html}\n</ul>"
  end
end

OrderedList = Struct.new(:items) do
  def to_html
    html = items.map { |i| "<li>#{i[:text]}</li>" }.join("\n")
    "<ol>\n#{html}\n</ol>"
  end
end

# Transform parse tree to AST
class MarkdownTransform < Parsanol::Transform
  rule(document: sequence(:blocks)) { Document.new(blocks) }

  rule(heading: { level: simple(:l), text: simple(:t) }) do
    Heading.new(l.to_s, t.to_s.strip)
  end

  rule(paragraph: sequence(:lines)) do
    Paragraph.new(lines.map(&:to_s))
  end

  rule(code_block: { language: simple(:lang), code: simple(:c) }) do
    CodeBlock.new(lang.to_s.strip, c.to_s)
  end

  rule(blockquote: { text: simple(:t) }) do
    Blockquote.new(t.to_s.strip)
  end

  rule(unordered_list: sequence(:items)) do
    UnorderedList.new(items)
  end

  rule(ordered_list: sequence(:items)) do
    OrderedList.new(items)
  end

  rule(item: { text: simple(:t) }) { { text: t.to_s.strip } }
  rule(item: { number: simple(:n), text: simple(:t) }) do
    { number: n.to_s, text: t.to_s.strip }
  end
end

# Parse markdown string
def parse_markdown(str)
  parser = MarkdownParser.new
  transform = MarkdownTransform.new

  tree = parser.parse(str)
  transform.apply(tree)
rescue Parsanol::ParseError => e
  puts "Parse error: #{e.message}"
  nil
end

# Main demo
if __FILE__ == $PROGRAM_NAME
  puts "Markdown Parser"
  puts "=" * 50
  puts

  markdown = <<~MD
    # Main Title

    This is a paragraph with **bold** and *italic* text.

    ## Second Heading

    > This is a blockquote

    - Item one
    - Item two
    - Item three

    1. First
    2. Second
    3. Third

    ```ruby
    def hello
      puts "Hello, World!"
    end
    ```
  MD

  puts "Input:"
  puts "-" * 50
  puts markdown
  puts "-" * 50
  puts

  result = parse_markdown("#{markdown}\n")

  if result
    puts "Parsed AST:"
    puts result.inspect
    puts
    puts "HTML Output:"
    puts result.to_html
  end
end