Simple Markup Parser
Parse a subset of Markdown-like markup with headers, lists, and inline formatting (bold, italic, code).
Key Concepts
- inline formatting
- block elements
- header levels
- list detection
- mixed content
Why Parse This Format?
Lightweight markup languages are essential for documentation, blogging, and content management. Understanding how to parse them enables building custom documentation tools.
Use Cases
- Documentation generation
- Blog and CMS content parsing
- README file processing
- Wiki markup conversion
- Custom markup extensions
Input Format
Simple markup with ATX-style headers (#, ##, ###), unordered lists (- or *), and inline formatting (**bold**, *italic*, `code`).
# Header | - list item | **bold** | *italic* | `code`Examples
# Main TitleVALIDLevel 1 header
## SectionVALIDLevel 2 header
- List itemVALIDUnordered list item
Text with **bold** and *italic*VALIDInline formatting
Use `code` inlineVALIDInline code
# Title\n\nParagraph text.\n\n- Item 1\n- Item 2VALIDFull document
Output Format
The parser returns a MarkupDocument containing MarkupElement enum values for each parsed element.
Structure
MarkupDocumentStruct with elements: Vec<MarkupElement>
MarkupElementEnum: Header{level, text}, Paragraph(String), ListItem(String), Bold(String), Italic(String), Code(String)
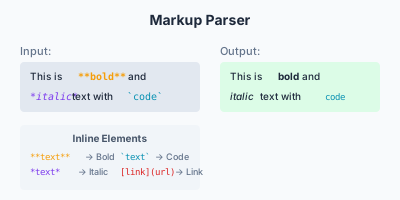
Visual Overview
How the Code Works
This section explains how the parsing rules map to the format semantics.
Inline Formatting
.rule(
    "bold",
    seq(vec![dynamic(str("**")), dynamic(re("[^*]+")), dynamic(str("**"))]),
)
.rule(
    "italic",
    seq(vec![dynamic(str("*")), dynamic(re("[^*]+")), dynamic(str("*"))]),
)
.rule(
    "code",
    seq(vec![dynamic(str("`")), dynamic(re("[^`]+")), dynamic(str("`"))]),
)
Inline elements use delimiter characters: Each format has opening and closing delimiters with content between.
Header Parsing
.rule("h1", seq(vec![dynamic(str("# ")), dynamic(re("[^\\n]+"))]))
.rule("h2", seq(vec![dynamic(str("## ")), dynamic(re("[^\\n]+"))]))
.rule("h3", seq(vec![dynamic(str("### ")), dynamic(re("[^\\n]+"))]))
Headers use `#` prefix for levels 1-3: The space after `#` is required; header text continues to end of line.
List Item Parsing
.rule(
    "list_item",
    seq(vec![
        dynamic(re("[ \t]*[-*][ \t]+")),  // marker with required space
        dynamic(re("[^\\n]+")),           // item text
    ]),
)
List items use `-` or `*` prefixes: Whitespace before the marker allows nested lists (visually).
Block Element Selection
.rule(
    "block",
    choice(vec![
        dynamic(seq(vec![dynamic(str("# ")), dynamic(re("[^\\n]+"))])),     // h1
        dynamic(seq(vec![dynamic(str("## ")), dynamic(re("[^\\n]+"))])),    // h2
        dynamic(seq(vec![dynamic(str("### ")), dynamic(re("[^\\n]+"))])),   // h3
        dynamic(seq(vec![dynamic(re("[ \t]*[-*][ \t]+")), dynamic(re("[^\\n]+"))])),  // list
        dynamic(re("[^\\n]+")),  // paragraph
    ]),
)
Blocks are parsed in priority order: Headers are tried first; if none match, the line is a paragraph.
Inline Formatting Processing
match c {
    '*' if chars.peek() == Some(&'*') => {
        chars.next();  // consume second *
        // Read until closing **
        let mut bold_text = String::new();
        while let Some(&next) = chars.peek() {
            if next == '*' {
                chars.next();
                if chars.peek() == Some(&'*') {
                    chars.next();
                    break;
                }
                bold_text.push('*');
            } else {
                bold_text.push(chars.next().unwrap());
            }
        }
        elements.push(MarkupElement::Bold(bold_text));
    }
    // ... italic and code similar
}
Inline elements are parsed character by character:
Source Code
//! Simple Markup Parser Example
//!
//! This example demonstrates parsing a simple markup language (like Markdown subset).
//! Shows handling of inline formatting, headers, and lists.
//!
//! Run with: cargo run --example markup_parser --no-default-features

#![allow(clippy::get_first)]

use parsanol::portable::{
    parser_dsl::{choice, dynamic, re, seq, str, GrammarBuilder},
    AstArena, Grammar, PortableParser,
};

/// Build a markup grammar
fn build_markup_grammar() -> Grammar {
    GrammarBuilder::new()
        // Inline: bold **text**, italic *text*, code `text`
        .rule(
            "bold",
            seq(vec![
                dynamic(str("**")),
                dynamic(re("[^*]+")),
                dynamic(str("**")),
            ]),
        )
        .rule(
            "italic",
            seq(vec![
                dynamic(str("*")),
                dynamic(re("[^*]+")),
                dynamic(str("*")),
            ]),
        )
        .rule(
            "code",
            seq(vec![
                dynamic(str("`")),
                dynamic(re("[^`]+")),
                dynamic(str("`")),
            ]),
        )
        // Header: # to ######
        .rule("h1", seq(vec![dynamic(str("# ")), dynamic(re("[^\\n]+"))]))
        .rule("h2", seq(vec![dynamic(str("## ")), dynamic(re("[^\\n]+"))]))
        .rule(
            "h3",
            seq(vec![dynamic(str("### ")), dynamic(re("[^\\n]+"))]),
        )
        // List item: - or * followed by text
        .rule(
            "list_item",
            seq(vec![
                dynamic(re("[ \t]*[-*][ \t]+")),
                dynamic(re("[^\\n]+")),
            ]),
        )
        // Paragraph: text until blank line or EOF
        .rule("paragraph", re("[^\\n]+(\\n[^\\n]+)*"))
        // Document: any of the above
        .rule(
            "block",
            choice(vec![
                dynamic(seq(vec![dynamic(str("# ")), dynamic(re("[^\\n]+"))])),
                dynamic(seq(vec![dynamic(str("## ")), dynamic(re("[^\\n]+"))])),
                dynamic(seq(vec![dynamic(str("### ")), dynamic(re("[^\\n]+"))])),
                dynamic(seq(vec![
                    dynamic(re("[ \t]*[-*][ \t]+")),
                    dynamic(re("[^\\n]+")),
                ])),
                dynamic(re("[^\\n]+")),
            ]),
        )
        .build()
}

/// Markup element types
#[derive(Debug, Clone)]
pub enum MarkupElement {
    /// Header with level and text
    Header { level: u8, text: String },
    /// Paragraph with raw text
    Paragraph(String),
    /// List item with text
    ListItem(String),
    /// Bold text
    Bold(String),
    /// Italic text
    Italic(String),
    /// Code inline
    Code(String),
}

impl std::fmt::Display for MarkupElement {
    fn fmt(&self, f: &mut std::fmt::Formatter<'_>) -> std::fmt::Result {
        match self {
            MarkupElement::Header { level, text } => {
                write!(f, "H{}: {}", level, text)
            }
            MarkupElement::Paragraph(text) => write!(f, "P: {}", text),
            MarkupElement::ListItem(text) => write!(f, "LI: {}", text),
            MarkupElement::Bold(text) => write!(f, "**{}**", text),
            MarkupElement::Italic(text) => write!(f, "*{}*", text),
            MarkupElement::Code(text) => write!(f, "`{}`", text),
        }
    }
}

/// Parsed markup document
#[derive(Debug, Clone, Default)]
pub struct MarkupDocument {
    pub elements: Vec<MarkupElement>,
}

/// Parse a markup string into structured elements
pub fn parse_markup(input: &str) -> Result<MarkupDocument, String> {
    let grammar = build_markup_grammar();
    let mut arena = AstArena::for_input(input.len());
    let mut parser = PortableParser::new(&grammar, input, &mut arena);
    let _ast = parser
        .parse()
        .map_err(|e| format!("Parse error: {:?}", e))?;

    // Manual parsing for clarity
    let mut doc = MarkupDocument::default();

    for line in input.lines() {
        let trimmed = line.trim();

        // Skip empty lines
        if trimmed.is_empty() {
            continue;
        }

        // Headers
        if let Some(stripped) = trimmed.strip_prefix("### ") {
            doc.elements.push(MarkupElement::Header {
                level: 3,
                text: stripped.to_string(),
            });
        } else if let Some(stripped) = trimmed.strip_prefix("## ") {
            doc.elements.push(MarkupElement::Header {
                level: 2,
                text: stripped.to_string(),
            });
        } else if let Some(stripped) = trimmed.strip_prefix("# ") {
            doc.elements.push(MarkupElement::Header {
                level: 1,
                text: stripped.to_string(),
            });
        }
        // List items
        else if let Some(stripped) = trimmed.strip_prefix("- ") {
            doc.elements
                .push(MarkupElement::ListItem(stripped.to_string()));
        } else if let Some(stripped) = trimmed.strip_prefix("* ") {
            doc.elements
                .push(MarkupElement::ListItem(stripped.to_string()));
        }
        // Regular paragraph
        else {
            doc.elements
                .push(MarkupElement::Paragraph(trimmed.to_string()));
        }
    }

    Ok(doc)
}

/// Parse inline formatting (bold, italic, code)
pub fn parse_inline(text: &str) -> Vec<MarkupElement> {
    let mut elements = Vec::new();
    let mut chars = text.chars().peekable();
    let mut current = String::new();

    while let Some(c) = chars.next() {
        match c {
            '*' if chars.peek() == Some(&'*') => {
                chars.next(); // consume second *
                if !current.is_empty() {
                    elements.push(MarkupElement::Paragraph(current.clone()));
                    current.clear();
                }
                // Read until closing **
                let mut bold_text = String::new();
                while let Some(&next) = chars.peek() {
                    if next == '*' {
                        chars.next();
                        if chars.peek() == Some(&'*') {
                            chars.next();
                            break;
                        }
                        bold_text.push('*');
                    } else {
                        bold_text.push(chars.next().unwrap());
                    }
                }
                elements.push(MarkupElement::Bold(bold_text));
            }
            '*' => {
                if !current.is_empty() {
                    elements.push(MarkupElement::Paragraph(current.clone()));
                    current.clear();
                }
                // Read until closing *
                let mut italic_text = String::new();
                while let Some(&next) = chars.peek() {
                    if next == '*' {
                        chars.next();
                        break;
                    }
                    italic_text.push(chars.next().unwrap());
                }
                elements.push(MarkupElement::Italic(italic_text));
            }
            '`' => {
                if !current.is_empty() {
                    elements.push(MarkupElement::Paragraph(current.clone()));
                    current.clear();
                }
                // Read until closing `
                let mut code_text = String::new();
                while let Some(&next) = chars.peek() {
                    if next == '`' {
                        chars.next();
                        break;
                    }
                    code_text.push(chars.next().unwrap());
                }
                elements.push(MarkupElement::Code(code_text));
            }
            _ => {
                current.push(c);
            }
        }
    }

    if !current.is_empty() {
        elements.push(MarkupElement::Paragraph(current));
    }

    elements
}

fn main() {
    println!("Simple Markup Parser Example");
    println!("============================\n");

    let markup = r#"
# Main Title

This is a paragraph with **bold** and *italic* text.

## Features

- Fast parsing
- Memory efficient
- Easy to use API

### Code Example

Here is some `inline code` for demonstration.

- Supports **nested** formatting
- Can parse *multiple* styles
"#;

    println!("Input Markup:");
    println!("-------------");
    println!("{}\n", markup);

    match parse_markup(markup) {
        Ok(doc) => {
            println!("Parsed Elements:");
            println!("----------------");
            for (i, element) in doc.elements.iter().enumerate() {
                println!("{}. {}", i + 1, element);
            }

            println!("\nInline Formatting Demo:");
            println!("-----------------------");
            let inline_text = "This has **bold**, *italic*, and `code` formatting";
            let inline_elements = parse_inline(inline_text);
            for element in inline_elements {
                println!("  {}", element);
            }
        }
        Err(e) => println!("Error: {}", e),
    }
}
# frozen_string_literal: true

# Markup Parser - Ruby Implementation
#
# Parse a simple markup language: headers, lists, paragraphs, inline formatting.
#
# Run with: ruby example/markup/basic.rb

$LOAD_PATH.unshift "#{File.dirname(__FILE__)}/../lib"

require "parsanol/parslet"

# Simple markup parser
class MarkupParser < Parsanol::Parser
  root :document

  # Document is a sequence of blocks
  rule(:document) { block.repeat(1).as(:document) }

  # Block-level elements
  rule(:block) do
    heading |
      unordered_list |
      paragraph |
      blank_line.as(:blank)
  end

  # Heading: = for H1, == for H2, === for H3
  rule(:heading) do
    (str("=").repeat(1, 3).as(:level) >>
     space >>
     heading_content.as(:text) >>
     newline).as(:heading)
  end

  rule(:heading_content) do
    (newline.absent? >> any).repeat(1)
  end

  # Paragraph: text until blank line
  rule(:paragraph) do
    (paragraph_line >> newline).repeat(1).as(:paragraph)
  end

  rule(:paragraph_line) do
    (blank_line.absent? >> (str("=").absent? | space.absent?) >> any).repeat(1)
  end

  # Unordered list: - items
  rule(:unordered_list) do
    list_item.repeat(1).as(:unordered_list)
  end

  rule(:list_item) do
    (str("-") >>
     space >>
     list_content.as(:text) >>
     newline).as(:item)
  end

  rule(:list_content) do
    (newline.absent? >> any).repeat(1)
  end

  # Helpers
  rule(:space) { str(" ") }
  rule(:newline) { match('\n') }
  rule(:blank_line) { match('\s').repeat >> newline }
end

# Markup node classes
MarkupDocument = Struct.new(:children) do
  def to_html
    children.map { |c| c.respond_to?(:to_html) ? c.to_html : "" }.join("\n")
  end
end

MarkupHeading = Struct.new(:level, :text) do
  def to_html
    h = level.length
    "<h#{h}>#{text.strip}</h#{h}>"
  end
end

MarkupParagraph = Struct.new(:lines) do
  def to_html
    content = lines.map(&:strip).join(" ")
    "<p>#{content}</p>" unless content.empty?
  end
end

MarkupList = Struct.new(:items) do
  def to_html
    html = items.map { |i| "<li>#{i[:text].strip}</li>" }.join("\n")
    "<ul>\n#{html}\n</ul>"
  end
end

# Transform parse tree to AST
class MarkupTransform < Parsanol::Transform
  rule(document: sequence(:blocks)) do
    MarkupDocument.new(blocks.reject { |b| b == :blank })
  end

  rule(heading: { level: simple(:l), text: simple(:t) }) do
    MarkupHeading.new(l.to_s, t.to_s)
  end

  rule(paragraph: sequence(:lines)) do
    MarkupParagraph.new(lines.map(&:to_s))
  end

  rule(unordered_list: sequence(:items)) do
    MarkupList.new(items)
  end

  rule(item: { text: simple(:t) }) { { text: t.to_s } }
  rule(blank: simple(:_)) { :blank }
end

# Parse markup string
def parse_markup(str)
  parser = MarkupParser.new
  transform = MarkupTransform.new

  tree = parser.parse(str)
  transform.apply(tree)
rescue Parsanol::ParseError => e
  puts "Parse error: #{e.message}"
  nil
end

# Main demo
if __FILE__ == $PROGRAM_NAME
  puts "Markup Parser"
  puts "=" * 50
  puts

  markup = <<~MU
    = Main Title

    This is a paragraph of text.
    It can span multiple lines.

    = Section One

    - First item
    - Second item
    - Third item

    == Subsection

    Another paragraph here.

    === Detail

    Final content.
  MU

  puts "Input:"
  puts "-" * 50
  puts markup
  puts "-" * 50
  puts

  result = parse_markup("#{markup}\n")

  if result
    puts "Parsed AST:"
    pp result
    puts
    puts "HTML Output:"
    puts result.to_html
  end
end